


Event Sourcing: omgaan met een bewogen verleden
We blijven in onze applicaties steeds dezelfde paradigma’s gebruiken voor gegevensopslag. Die standaardoplossingen waren niet voor niets de standaard, maar er zijn daarbij ook compromissen gesloten. Deze patronen zijn zo diep geworteld in onze sector dat we vergeten ze in twijfel te trekken, ook al zijn er tegenwoordig wellicht betere oplossingen voor die problemen.
De afwegingen die we hebben overgenomen
Als we kijken naar de huidige verdeling van het databasgebruik, zien we dat relationele, op SQL gebaseerde databases nog steeds de ranglijst domineren. En zelfs in onze informaticaopleidingen leren we nieuwe ontwikkelaars nog steeds om hun gegevens te normaliseren en in eerste instantie naar SQL te grijpen. Dat instinct is niet verkeerd, maar wordt zelden onder de loep genomen.
De Structured Query Language (SQL) werd in de jaren zeventig gespecificeerd en werd in 1986 een ANSI-standaard. De hardware uit die tijd bepaalde de prioriteiten. Hoewel het soort gestructureerde gegevens dat werd opgeslagen niet zo heel veel verschilt van het huidige, waren harde schijven klein en duur. Vaak waren ze een paar keer zo duur als de computers waarop ze waren aangesloten. In die wereld was het opslaan van welk stukje informatie dan ook twee keer bijna nalatigheid. Normalisatie was niet alleen een net idee, het was een economische noodzaak.
Het relationele model werd dus afgestemd om het maximale uit de schaarse, dure opslagruimte te halen, en dat is gelukt. Wanneer we gegevens normaliseren, winnen we op drie fronten. We winnen aan gegevensintegriteit, omdat elk feit op één plek staat en zichzelf niet kan tegenspreken. We winnen aan consistentie, omdat ACID-transacties ons in staat stellen die ene kopie te wijzigen met sterke garanties. En we winnen schijfruimte, omdat niets wordt gedupliceerd.
Maar we vergeten vaak wat we hebben opgeofferd om dit te bereiken. Wat vaak buiten beschouwing blijft, is wat we hebben opgegeven om deze voordelen te verkrijgen. In ruil daarvoor hebben we drie dingen opgeofferd:
- Prestaties: We halen vaak gegevens op uit complete grafieken, verspreid over verschillende tabellen. Hiervoor zijn database-joins nodig. Dit kost niet alleen rekenkracht, maar deze rekenkracht is ook moeilijk te verdelen en te schalen, aangezien deze in de database-engine zelf wordt uitgevoerd.
- Geschiedenis: Bij onze optimalisatie voor opslag geeft onze database alleen de huidige toestand van de gegevens weer. Elke oude versie van de records gaat verloren wanneer het record wordt overschreven.
- Concurrency: Aangezien we ACID-conformiteit moeten garanderen en gegevens door meerdere schrijvers kunnen worden bewerkt, moeten we concurrency-problemen aanpakken, hetzij op optimistische, hetzij op pessimistische wijze.
Waarom de oude afwegingen niet langer gelden
Vraag jezelf nu eens af wanneer je je voor het laatst zorgen hebt gemaakt over schijfruimte op een cloudfactuur. Opslag staat onderaan de lijst, ver onder rekenkracht, geheugen en netwerk. De enige beperking die de hele opzet rechtvaardigde, die duplicatie ondenkbaar maakte, is in feite verdwenen.
We accepteerden tragere leesbewerkingen, lock-conflicten en het verlies van gegevens uit het verleden in ruil voor het besparen van de enige hulpbron die sindsdien goedkoop is geworden. Als we bereid zijn weer meer opslagruimte te gebruiken, kunnen we alle drie de dingen die we kwijtgeraakt zijn terugkopen: onze geschiedenis, de ontlasting van de database door het wegvallen van join-bewerkingen, en een einde aan de strijd om schrijfvergrendelingen. Dat is de afweging die event sourcing helpt te realiseren, zelfs als we het bovenop een relationele database-engine gebruiken.
Wat is event sourcing?
Kijk eens naar vrijwel elk softwaresysteem dat we bouwen. Er komt een commando binnen, een verzoek aan het systeem om iets te doen, of dat nu komt door het indrukken van een knop, een bericht op een bus of een API-aanroep. Er wordt code aangeroepen om het werk uit te voeren, meestal door de huidige toestand te lezen, logica toe te passen en iets terug te schrijven. Uiteindelijk geeft het systeem aan dat er iets is gebeurd. Laten we die uitkomsten ‘gebeurtenissen’ noemen.
Het helpt om deze drie zaken in de tijd te bekijken. Een commando heeft betrekking op de toekomst; het is een verzoek dat nog niet is ingewilligd. De toestand vertegenwoordigt het heden: hoe de gegevens van het systeem er op dit moment uitzien. Een gebeurtenis heeft betrekking op het verleden: iets dat al is gebeurd en, aangezien we geen tijdmachine hebben, niet kan worden gewijzigd. De toestand is in deze visie de manier waarop ons systeem informatie doorgeeft aan zijn toekomstige zelf, zodat de volgende opdracht iets heeft om op voort te bouwen. De vraag die event sourcing stelt, is of de toestand het beste bericht is om door te geven, of dat we het beter kunnen doen door expliciet te zijn over de gebeurtenissen die die toestand in de eerste plaats hebben voortgebracht.
De toestand van een systeem is altijd het resultaat van de gebeurtenissen die in het verleden in een systeem hebben plaatsgevonden. Dit wijst op een asymmetrie die de kern van het idee vormt. Als je de gebeurtenissen bewaart, kun je de toestand altijd reconstrueren door ze in de juiste volgorde af te spelen. Het omgekeerde geldt niet: als je alleen de eindtoestand hebt, kun je de gebeurtenissen die deze hebben voortgebracht niet op betrouwbare wijze achterhalen. De toestand is een compressie van de geschiedenis waarbij informatie verloren gaat, en als je eenmaal hebt gecomprimeerd, kun je niet meer decomprimeren.
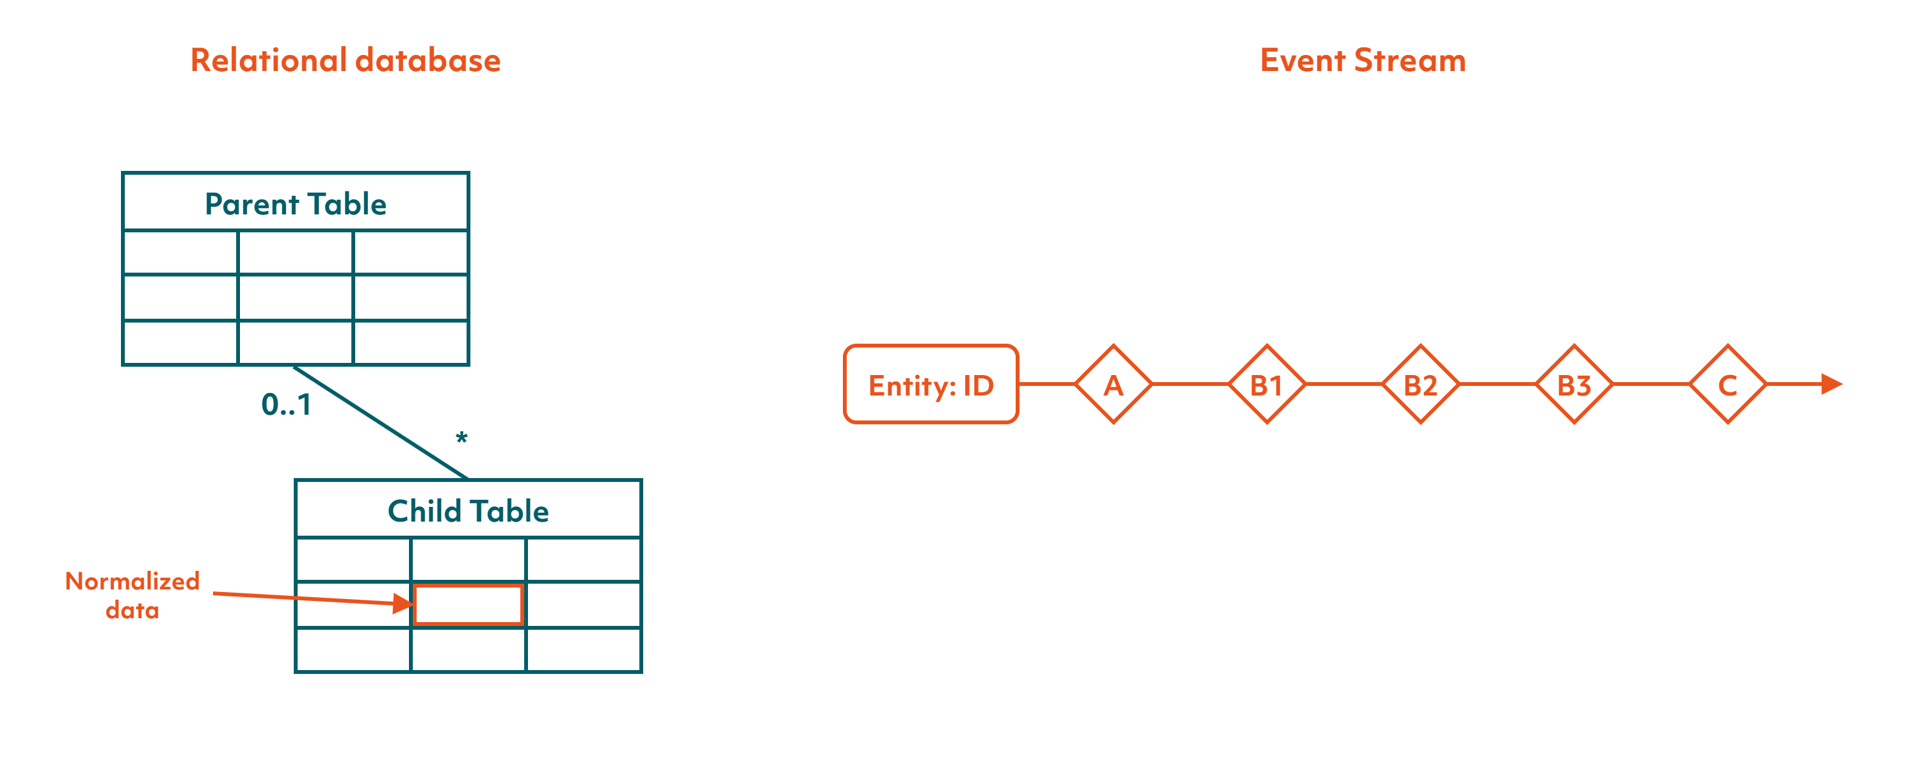
Bij event sourcing worden de gebeurtenissen dus opgeslagen. In plaats van een genormaliseerde reeks tabellen die een entiteit en haar onderliggende entiteiten weergeven – waarbij records worden overschreven – behandelen we die entiteitsinstantie als een stroom van gebeurtenissen uit het verleden. Wanneer gegevens veranderen, voegen we de bijbehorende gebeurtenissen op volgorde toe aan de stroom. De voordelen vloeien hier direct uit voort. We voegen alleen toe aan het einde van een stroom, dus schrijven vereist geen vergrendelingen. We overschrijven nooit, dus behouden we de volledige geschiedenis. En we verlichten de belasting van joins, omdat het reconstrueren van een entiteit een sequentiële lezing van één stroom is in plaats van een fan-out over tabellen heen. De kosten die we nu kiezen te maken, zijn meer opslagruimte, aangezien de gegevens uitgebreider zijn en redundantie bevatten – een afweging die de meeste systemen tegenwoordig gemakkelijk kunnen maken.
De levenscyclus van de opdrachtverwerker
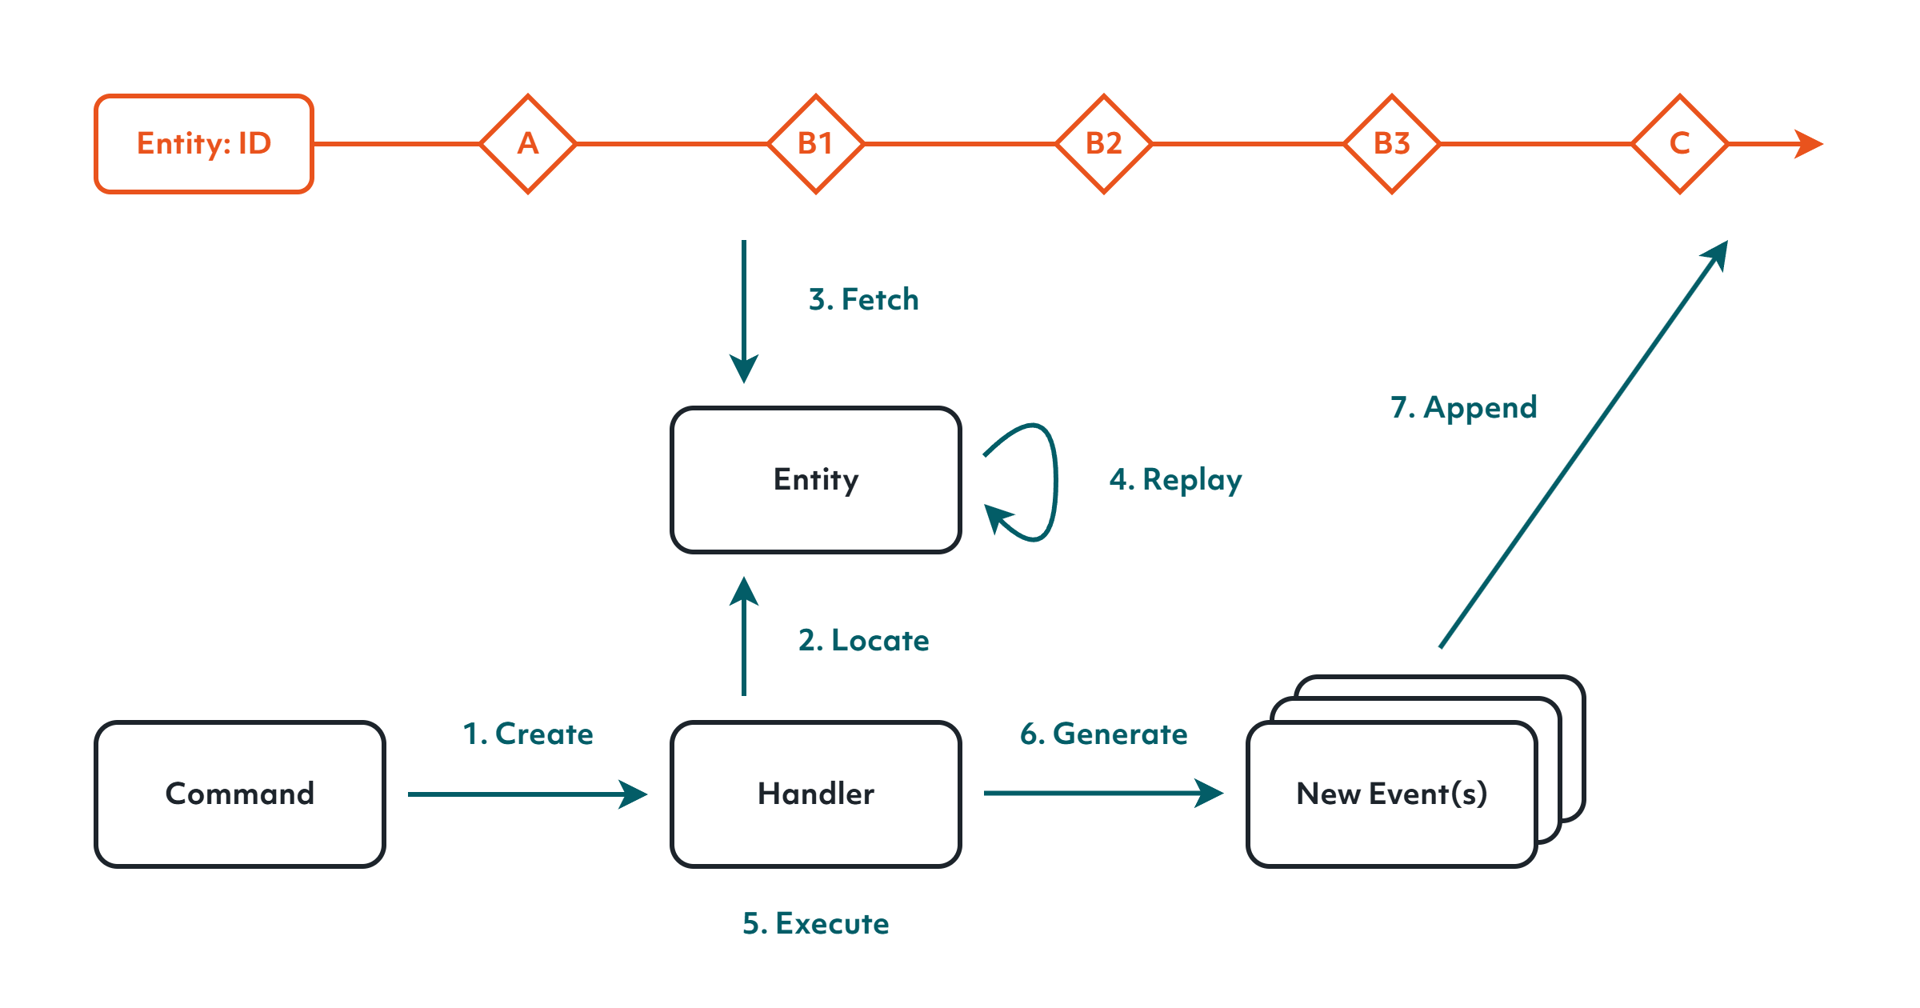
Omdat we geen status meer opslaan, verloopt de afhandeling van een commando achter de schermen iets anders. Een commandohandler is nog steeds gewoon een functie in een klasse, en zijn eerste taak is bekend: hij zoekt de entiteit waarop hij moet reageren. Maar nu is de status van die entiteit niet meer opgeslagen in ons opslagsysteem. In plaats van een rij te laden, halen we dus alle gebeurtenissen uit de stream van die entiteit op en spelen we die opnieuw af om de status van de entiteit in het geheugen te reconstrueren. De handler voert vervolgens zijn logica uit en in plaats van terug te schrijven naar de statustabel, genereert hij nieuwe gebeurtenissen. Deze nieuwe gebeurtenissen worden aan het einde van de stream toegevoegd. Volgende commando’s voor dezelfde entiteit krijgen een bijgewerkte stream, omdat de nieuwe gebeurtenissen ook worden opgehaald. Dat is de hele cyclus: de stream lokaliseren, de gebeurtenissen ophalen, ze opnieuw afspelen om de status te reconstrueren, de logica uitvoeren en nieuwe gebeurtenissen toevoegen.
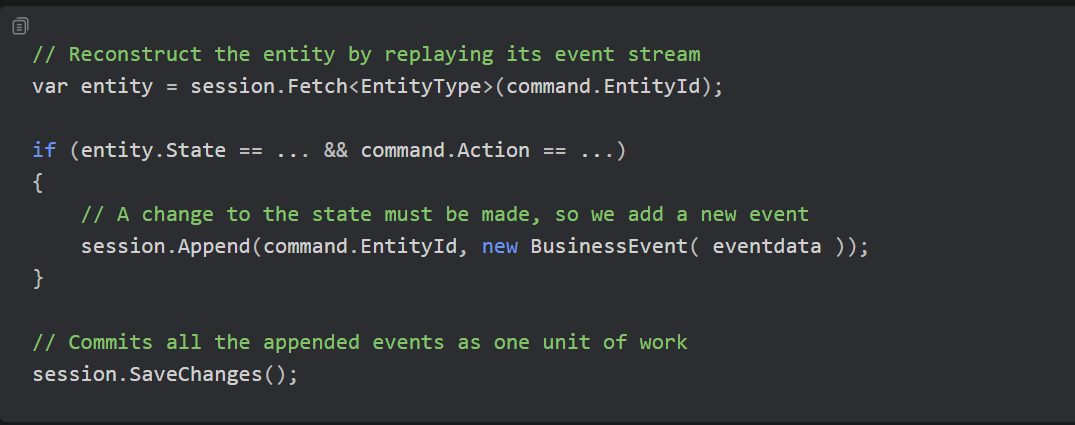
In de praktijk schrijf je dit allemaal niet dagelijks met de hand. Een framework zorgt voor het ophalen en weergeven, en je handler lijkt sterk op de code die je tegenwoordig voor een ORM zou schrijven. Je kunt je eigen event sourcing-framework zelf programmeren, of een bestaand framework gebruiken, maar de code komt elke ontwikkelaar die tegenwoordig een ORM gebruikt zeer bekend voor.
Een vraag die vaak wordt gesteld, is waarom we gebeurtenissen opslaan in plaats van commando’s, aangezien het commando toch als eerste binnenkwam. Daar zijn twee goede redenen voor. Ten eerste vindt een groot deel van het zware werk, inclusief neveneffecten zoals aanroepen van externe systemen, plaats tijdens de verwerking van het commando. Als we commando’s zouden herhalen, zouden die neveneffecten elke keer opnieuw worden uitgevoerd. Ten tweede is de logica van de handler de code die het meest waarschijnlijk verandert: als je hetzelfde commando opnieuw afspeelt nadat de bedrijfsregels zijn gewijzigd, krijg je andere gebeurtenissen dan oorspronkelijk, wat de historische gegevens vervuilt.
Een opgeslagen gebeurtenis daarentegen is een feit dat waar was op het moment dat het werd vastgelegd, dus het opnieuw afspelen ervan vereist geen validatie en geen neveneffecten en is grotendeels een kwestie van velden in een object instellen. Enkele duizenden gebeurtenissen kunnen in een paar milliseconden worden afgespeeld. De gebeurtenissen zelf kunnen het best worden gemodelleerd als een onveranderlijke gegevensstructuur, wat een diepere waarheid weerspiegelt: ze zijn ook in de loop van de tijd onveranderlijk in het systeem.
Het opslaan van gebeurtenissen kan op een heel eenvoudige manier worden bekeken en vereist de volgende velden:
- Stream-ID: de entiteits-ID waartoe de gebeurtenis behoort.
- Volgnummer: de volgorde van de gebeurtenis binnen de geschiedenis van deze entiteit.
- Gebeurtenisgegevens: de (geserialiseerde) weergave van de gebeurtenis.
- Gebeurtenistype: het type gebeurtenis. Dit helpt bij het deserialiseren en filteren.
- Metadata: We kunnen aanvullende gegevens toevoegen, zoals tijdstempels, correlatie-ID’s, enz.
Conceptueel gezien is dit een tabel die alleen kan worden aangevuld (append-only) en die je desgewenst in een relationele database kunt plaatsen; omdat er geen joins nodig zijn, is deze eenvoudig te optimaliseren. Het toevoegen van een unieke beperking op de stream-ID en het volgnummer helpt bij het oplossen van concurrency-problemen tussen threads die naar dezelfde stream proberen te schrijven.
Om gebeurtenissen opnieuw af te spelen en zo de toestand van de entiteit te reconstrueren, hebben we alleen enkele eenvoudige `apply`-methoden in de entiteitsklasse nodig. Deze nemen de gebeurtenissen die opnieuw moeten worden afgespeeld als invoer en wijzigen op hun beurt de toestand van de entiteitsinstantie. Uiteindelijk hebt u één ‘apply’-methode per gebeurtenistype, die de statuswijziging van deze gebeurtenis voor die entiteit afhandelt. Deze ‘apply’-methoden zijn vrij van neveneffecten en lokaal, dus als u er één bekijkt, ziet u precies hoe een bepaalde gebeurtenis de entiteit verandert. Iemand die niet bekend is met de codebase kan inzicht krijgen in het model door ze te lezen.
Hoe dit aansluit bij CQRS
Event sourcing wordt vaak in één adem genoemd met CQRS en domeingestuurd ontwerpen. Het zijn drie afzonderlijke concepten, maar ze sluiten buitengewoon goed op elkaar aan.
Laten we beginnen met Command-Query Responsibility Segregation, oftewel CQRS. De ideeën achter CQRS kunnen kort als volgt worden samengevat:
- Command-kant: De command-zijde van het systeem is niet verantwoordelijk voor het retourneren van resultaten, maar verwerkt uitsluitend commando’s op basis van de toestand van het systeem.
- Query-kant: De query-kant van het systeem retourneert resultaten, maar verandert de toestand niet.
- Modellen: Om de prestaties aan beide kanten te optimaliseren, gebruiken we verschillende modellen voor query’s en commando’s.
- Actualisatie: Om de database van de query-kant (de read store) up-to-date te houden, hebben we een actualisatiemechanisme nodig. De meest efficiënte manier om dit te doen is door projecties te schrijven die gebeurtenissen verwerken die door de command-kant worden gegenereerd.
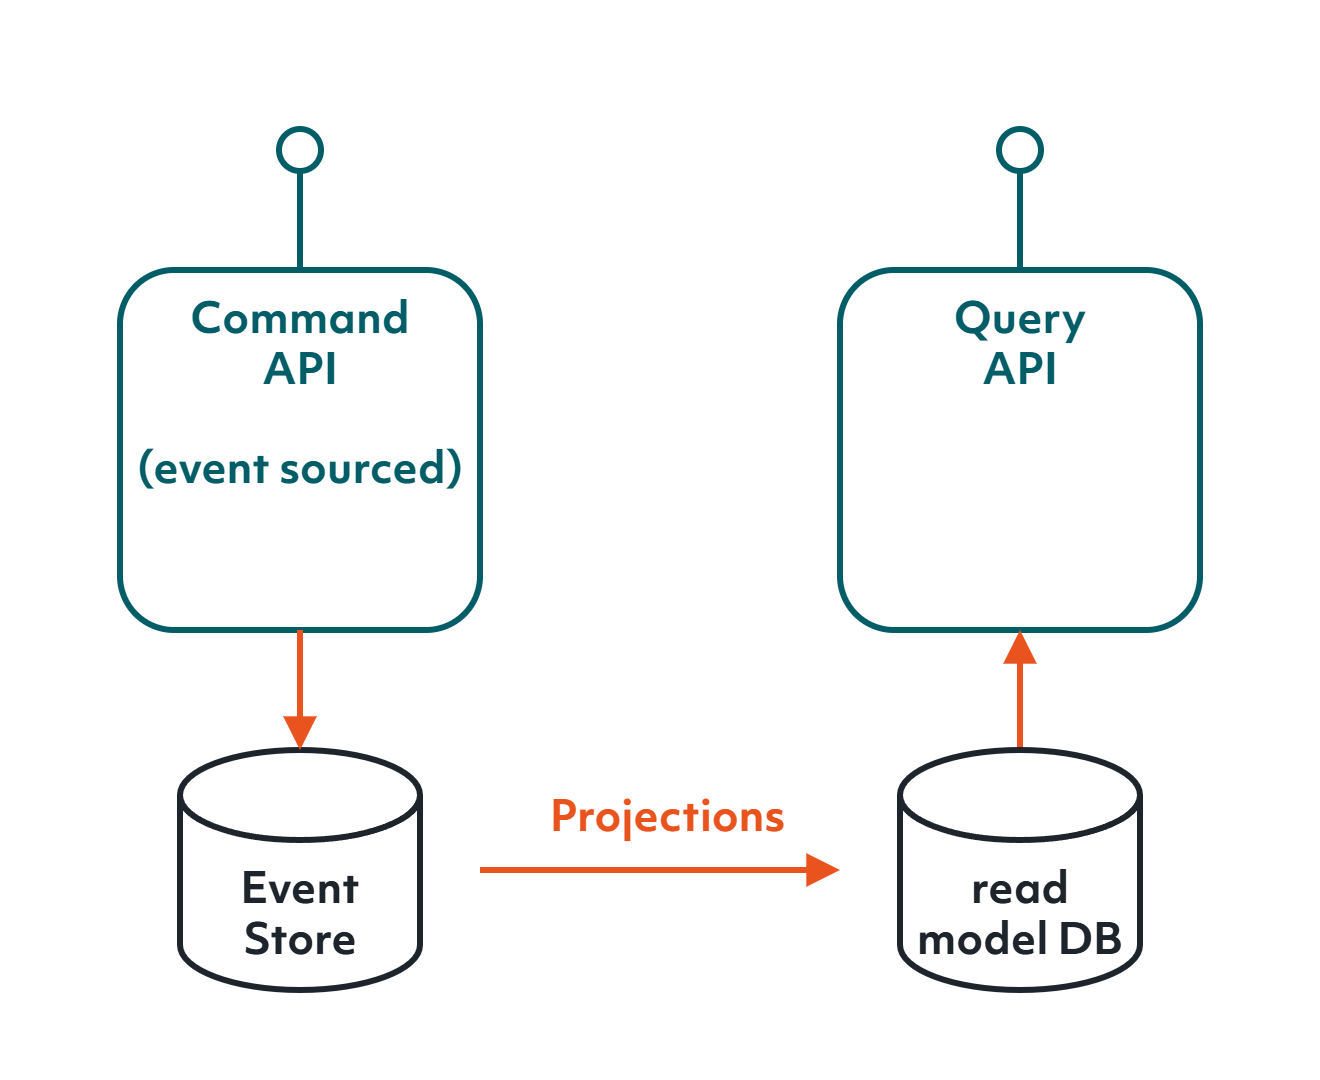
Als we onze command-side schrijven volgens een event-sourced model, dan kunnen onze bedrijfsgebeurtenissen die daar worden opgeslagen dezelfde gebeurtenissen zijn die de projecties voeden om de read store bij te werken. Dit is precies waarom event sourcing en CQRS zo goed bij elkaar passen, omdat het de praktische discrepantie tussen de gebeurtenissen en de toestand wegneemt. We zullen precies dezelfde bedrijfsgebeurtenissen gebruiken om naar de gebeurtenissenstroom van de command-side te schrijven als degene die we genereren om onze projecties te voeden.
Hoe prognoses werken
Het mechanisme waarmee de inhoud van een query-side-tabel wordt opgebouwd, is een projectie. Een projectie is een stukje code dat zich abonneert op specifieke gebeurtenissen, deze filtert zodat alleen de relevante gebeurtenissen worden weergegeven, en deze vervolgens gebruikt om records in een leesmodel aan te maken, bij te werken of te verwijderen. Het leesmodel kan een documentopslag, een relationele tabel of iets anders zijn. Op deze manier zet de projectie gebeurtenissen om in een gegevensstructuur die geschikt is voor query’s.
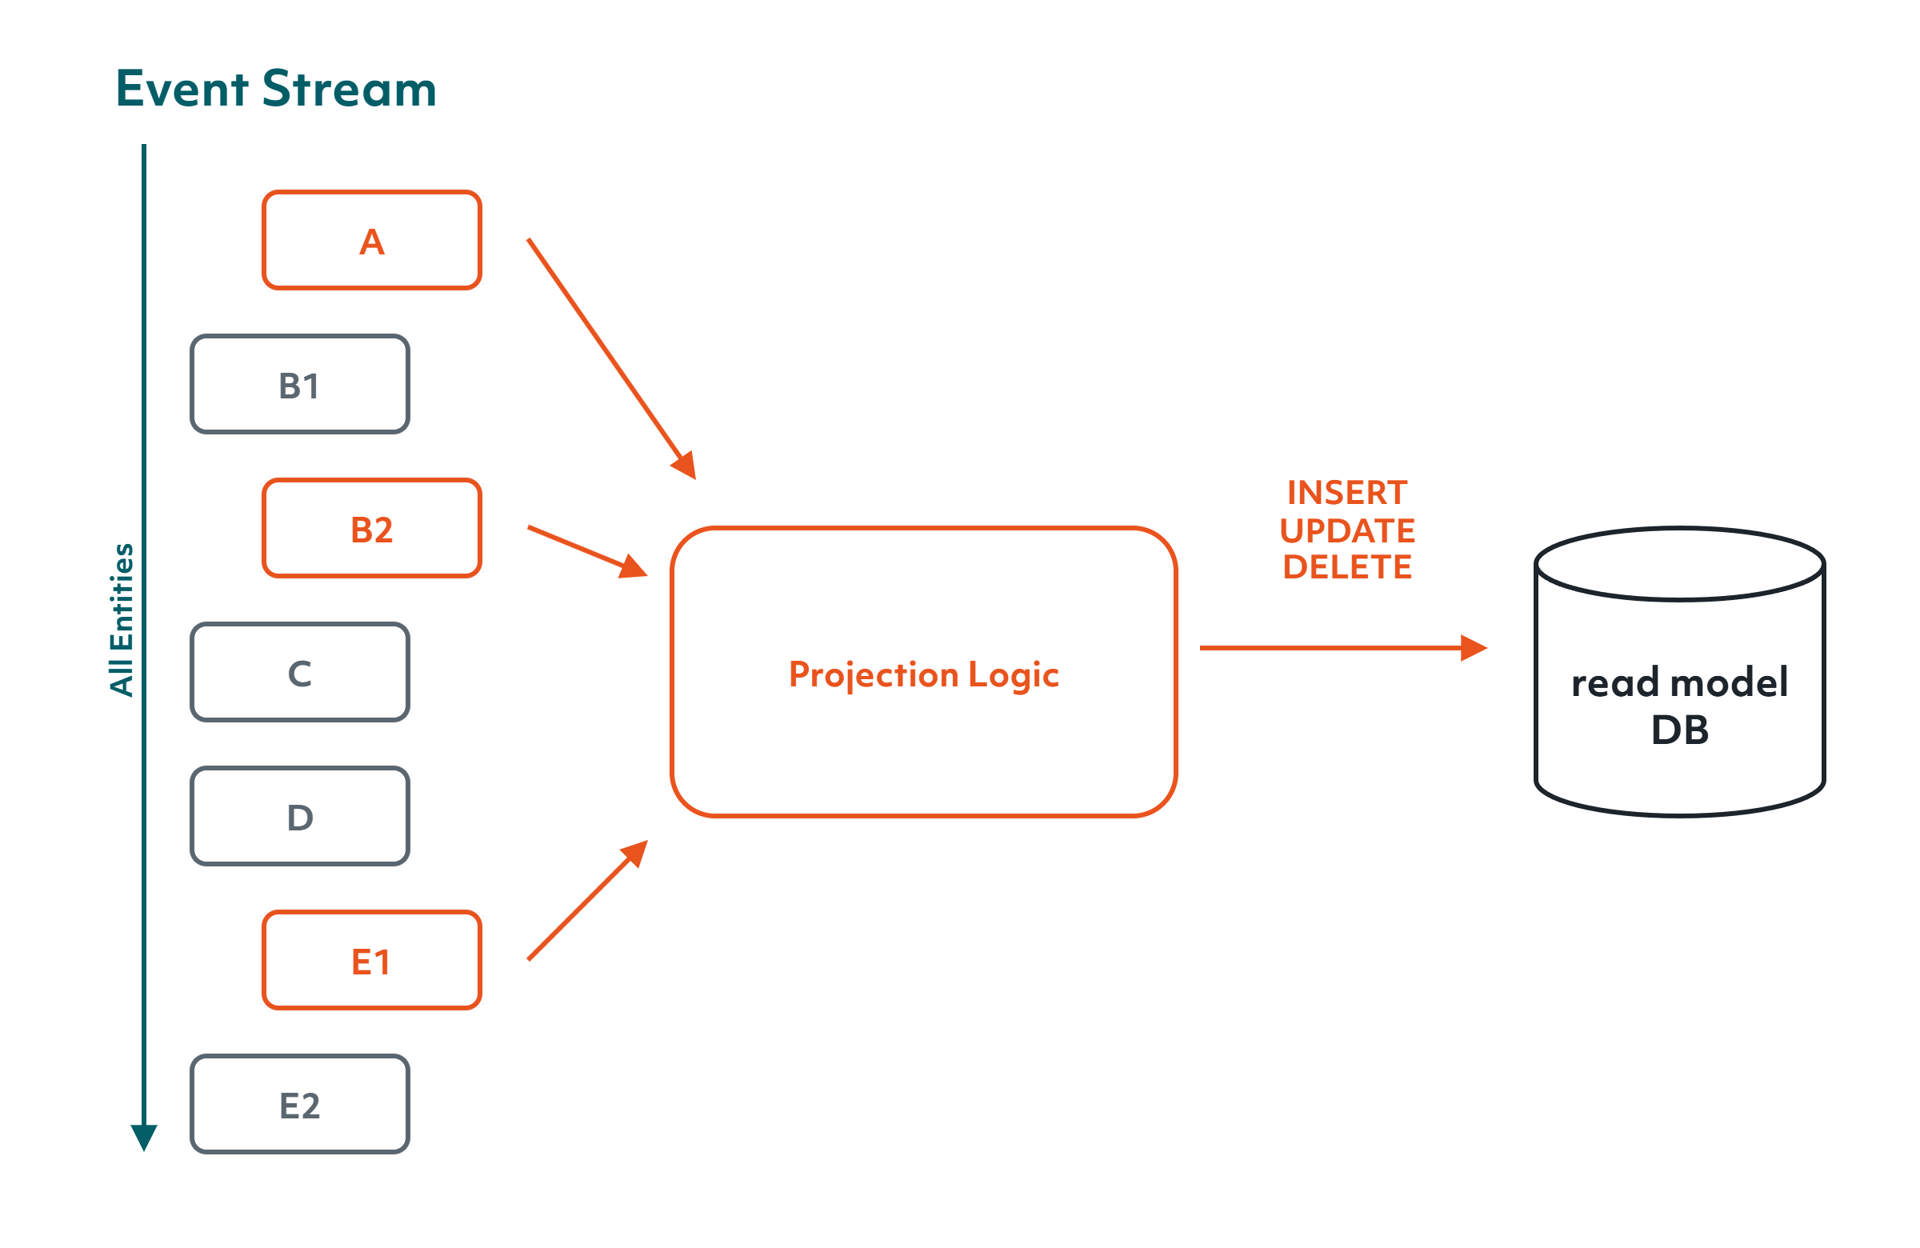
Er valt veel te zeggen over projecties en hoe ze in een systeem kunnen worden afgestemd. Maar ik denk dat er twee eigenschappen van projecties zijn die hier het belangrijkst zijn.
De eerste is isolatie. Elke projectie heeft geen invloed op iets anders in het systeem, en haar enige taak is het vullen van een bepaalde tabel of een bepaalde set tabellen in de query store. Die gegevens zijn eigendom van de projectie, en niets anders schrijft ernaar. Hierdoor zijn de invoer en uitvoer van een projectie volledig vrij van neveneffecten, en is het verder ontwikkelen van de code en het systeem als geheel zeer voorspelbaar.
De tweede eigenschap is dat projecties een oplossing bieden voor een probleem dat bij genormaliseerde databases vaak lastig was: nieuwe eisen aan oude gegevens. Stel dat het bedrijf vraagt om een inzicht waarvoor informatie nodig is die we nooit hadden overwogen om in een doorzoekbare vorm op te slaan. Met een genormaliseerd schema zouden we migratiescripts moeten schrijven en vaak onze toevlucht moeten nemen tot giswerk om de tabellen achteraf te vullen. Met event sourcing is de geschiedenis al aanwezig in de gebeurtenissen. We schrijven de projectie die we toch al zouden hebben geschreven, richten deze op de bestaande stream en laten deze vanaf het begin opnieuw afspelen, wat resulteert in een leesmodel dat is opgebouwd uit echte geschiedenis in plaats van gereconstrueerde schattingen.
Dankzij diezelfde eigenschap kunnen projecties eenvoudig worden aangepast. Als de logica moet worden gewijzigd, verwijder je de leestabel en bouw je deze opnieuw op vanuit de stream volgens de nieuwe logica. Omdat een projectie alleen naar haar eigen leesmodel schrijft en geen invloed heeft op de opdrachtzijde of op andere projecties, is het veilig om een projectie opnieuw op te bouwen, waardoor het risico bij het verder ontwikkelen van dat deel van het systeem laag is.
Waarom dit goed past bij domeingestuurd ontwerpen
Bij ‘domain-driven’ gaat het erom dat het bedrijfsdomein de architectuur en de code bepaalt. De oorspronkelijke filosofie is om de code zoveel mogelijk de echte taal, terminologie en gedragingen van het bedrijf dat erdoor wordt ondersteund, te laten weerspiegelen. Dit heeft niet alleen invloed op de uiteindelijke code, maar bepaalt ook hoe gesprekken tussen ontwikkelaars en domeinexperts van de zakelijke kant van de organisatie verlopen. Je hebt vast wel eens teams gezien die rond een muur met plakbriefjes staan. Technieken zoals event storming en event modeling maken precies gebruik van die werkwijze om een bedrijfsproces in kaart te brengen voordat er ook maar één regel code wordt geschreven, waarbij een kleurgecodeerde woordenschat wordt gebruikt voor commando’s, gebeurtenissen, projecties en leesmodellen.
En dat is precies waar het zo naadloos aansluit. In die workshops komt elk plakbriefje overeen met een concept in het systeem, en met event sourcing wordt elk briefje min of meer één-op-één een klasse: opdrachtbriefjes worden opdrachten, gebeurtenisbriefjes worden gebeurtenissen, leesmodelbriefjes worden projecties. Er is geen tussenstap waarin iemand beslist hoe dit alles moet worden omgezet in een genormaliseerd schema, en juist bij die vertaling – van de taal van het bedrijf naar de taal van tabellen – gaat de betekenis verloren. Event sourcing neemt deze wrijving weg. Het model dat je met de domeinexperts hebt besproken, is het model dat je in code vastlegt, en dat is precies wat domeingestuurd ontwerpen probeert te bereiken.
Isolatie en prestatieoptimalisatie
Een volwaardig CQRS-systeem bestaat uit een verzameling kleinere onderdelen: command-handlers, projecties, een query-API met een leesopslag, event-abonnementen voor integraties, enzovoort. Het mooie hiervan is dat elk stukje code relatief geïsoleerd draait, met zeer beperkte neveneffecten. Dit betekent dat de onderdelen van een CQRS-systeem onafhankelijk van elkaar kunnen worden afgestemd, aangezien de bewerkingen geen invloed hebben op andere delen van het systeem of op de bijbehorende onderdelen.
De standaardmodus voor een CQRS-systeem is ‘uiteindelijk consistent’ tussen de opdracht- en de queryzijde. Om zakelijke of prestatieredenen kunnen we voor bepaalde soorten bewerkingen van die strategie afwijken. We zouden onmiddellijke consistentie kunnen afdwingen, ten koste van een tragere verwerking van opdrachten. Of we zouden de verwerking van een projectie kunnen uitstellen totdat er get-query’s voor worden uitgevoerd, waardoor de initiële kosten voor het vullen van een leesopslag worden beperkt. Beide opties zouden alleen in speciale gevallen moeten worden toegepast, maar zijn, afhankelijk van uw opzet, heel goed haalbaar.
Lange streams brengen een verwant probleem met zich mee. Een entiteit die miljoenen gebeurtenissen verzamelt, zou bij elke opdracht traag zijn bij het opnieuw afspelen. Snapshots bieden hiervoor een oplossing: wanneer de stream lang wordt, berekenen we de toestand van de entiteit tot een bepaald punt in de stream en slaan we deze apart op. Dit betekent dat de volgende opdracht eerst de snapshot kan laden en alleen de gebeurtenissen na dat punt opnieuw kan afspelen.
Waarom dit werkt in het tijdperk van AI
Het argument voor event sourcing is altijd gebaseerd geweest op het dichter bij elkaar brengen van het bedrijfsdomein en de code. Twee gevolgen van die nauwe koppeling werpen nu hun vruchten af bij het werken met AI-modellen.
De eerste is de afwezigheid van neveneffecten. De belangrijkste bouwstenen – de command handlers, de projecties, de event subscriptions, enzovoort – zijn allemaal vrij van neveneffecten binnen het systeem zelf. De code wordt ook niet hergebruikt in andere codepaden. Rond dit soort code is het eenvoudig om een context op te bouwen, waardoor deze gemakkelijk te ontwikkelen is, of de persoon die de wijziging aanbrengt nu een menselijke ontwikkelaar is of een AI-model. En juist dit gebrek aan verborgen koppeling vermindert het risico dat een lokale wijziging ergens anders iets kapotmaakt. Projecties kunnen worden verwijderd en opnieuw worden opgebouwd, wat een model een veilige ruimte biedt om wijzigingen aan te brengen waarvan de effecten eenvoudig te verifiëren zijn door ze opnieuw af te spelen. Voorspelbare, geïsoleerde code is precies het soort code waar geautomatiseerde tools goed mee overweg kunnen.
Het tweede voordeel is de nauwe aansluiting bij de bedrijfstaal. Omdat commando’s, gebeurtenissen en projecties rechtstreeks aansluiten bij de manier waarop het bedrijf zijn eigen processen beschrijft, zijn de namen in de code dezelfde als die welke de domeinexperts gebruiken. Wanneer je een specificatiegestuurd framework gebruikt om je functies in een softwaresysteem te beheren, zullen die specificaties nauw aansluiten bij de daadwerkelijke code waarmee deze specificaties worden geïmplementeerd. Nogmaals: wat een junior ontwikkelaar helpt zijn weg te vinden in ons systeem, is ook wat een LLM helpt om de juiste wijzigingen aan te brengen binnen de context die het krijgt aangereikt.
Waar starten?
Je hoeft dit allemaal niet helemaal zelf op te bouwen, en dat zou je ook niet moeten doen. In de meeste ecosystemen zijn er volwassen frameworks en speciaal ontwikkelde dataopslagengines beschikbaar. Hier volgen enkele voorbeelden:
- Marten: een .NET-documentdatabase, event store en projectiesysteem bovenop PostgreSQL.
- Axoniq: een JVM-framework voor event-gedreven ontwikkeling, inclusief event sourcing.
- Emmett: een TypeScript-framework voor event sourcing.
- Python-event sourcing: Python beschikt over verschillende event sourcing-pakketten.
- Kurrent: Voorheen Event Store genoemd, is een eigen engine met clients in vele talen.
- EventSourcingDB: Dit is een relatief nieuwe, speciaal ontwikkelde event store in Go die uitsluitend toevoegingen toestaat. Het beschikt over clientbibliotheken in vele talen. Het wordt volledig ondersteund in OpenCQRS op de JVM.
Wat betreft de vraag die je je waarschijnlijk stelt: wanneer ga ik hiermee aan de slag? Het sterkste signaal is niet van technische aard. Event sourcing wordt een natuurlijke manier om je code te structureren zodra je ermee vertrouwd raakt. Het echte voordeel komt echter pas wanneer je met je zakelijke collega’s kunt praten in termen van commando’s en gebeurtenissen terwijl je hun processen in kaart brengt. Op dat moment is het omzetten van die gesprekken in code bijna een mechanisch proces, omdat elk concept een directe overeenkomst heeft. Dat vereist wel dat de mensen eerst op deze manier gaan denken. De moeilijkste problemen zijn altijd menselijke problemen, geen technische. Zorg dat het gesprek goed verloopt en de architectuur volgt vanzelf. Het komt zowel de mensen in het team ten goede als de (AI- en andere) modellen die ze gebruiken om hun applicaties te bouwen.